32|大数据(二):大数据思维的四个层次
32|大数据(二):大数据思维的四个层次
你好,欢迎来到我的《信息论40讲》。
我们上一讲说了大数据的特点,今天来谈谈大数据思维。
说到大数据,就不得不说说它的英文名称Big Data。不知道你有没有想过,它为什么叫Big Data,而不叫Large Data,或者叫Vast Data、Huge Data,等等?Large、vast和huge都是指体量大,在程度上,后二者可以看成是very large的意思,比large更大。
但是,Big和它们的差别却在于它是强调相对抽象意义上的大,而并非具体的。
比如说,“Large Table”常常表示一张桌子尺寸很大,而如果说“Big Table”并不强调尺寸,只是要强调已经称得上大了,比较抽象。因此,仔细推敲Big Data这种说法,我们不得不承认它非常准确,最重要的是它传递了一种信息——大数据是一种思维方式的改变。
我们过去说,量变会带来质变,那常常是在一个维度上说的, 而今天我们说大数据思维,已经超出了这一层含义,是一种全新的思维方式和做事情的方法。
今天大部分人所理解的大数据,是从大量的、看似杂乱无章的数据点,总结出原来找不到的相关性。在这个过程中各种数据如同百川入海一般汇聚到一起。我们在前面已经举了不少这一类的例子。 但这只是大数据思维的第一层含义。
我们需要强调的是,大数据思维和过去通过大量数据验证一件事还是有区别的。那就是由于这些数据在产生和收集时是没有特定目的的,因此怎样使用它们,则需要视特定的应用而定。
比如Google趋势这个产品就用到了大数据,由于收集数据事先没有目的性,从这些数据中能够得到什么结果事先也不知晓,这让它发现了很多过去没有想到的规律。
为了更清晰地说明这一点,我们不妨看一个大数据在医疗制药方面的应用。
我在《文明之光》和《全球科技通史》中介绍了青霉素漫长的研制过程。今天几乎所有的新药的研制过程都和青霉素很类似:科学家们通常需要分析疾病产生的原因,寻找能够消除这些原因的物质,然后合成新药。
这个非常漫长的过程导致药品研制的周期很长,斯坦福医学院院长米纳(Lloyd Minor)教授估计,从最重要的那篇研究论文发表算起,到新药上市,平均需要20年的时间。
另一方面,研制的资金投入也是巨大的,通常需要20亿美元。这也就不奇怪为什么有效的新药价格都非常昂贵,因为如果不能在专利有效期内 挣回20亿美元的成本,就不可能有公司愿意投钱研制新药了。
今天,有了大数据,寻找特效药的方法就和过去有所不同了。世界上一共只有大约5000多种被批准上市的药,人类会得的疾病大约有一万种,包括很罕见的疾病。如果将每一种药和每一种疾病进行配对,就会发现一些意外的惊喜。
比如斯坦福大学医学院发现,原来用于治疗心脏病的某种药物,对治疗某种胃病特别有效。当然,为了证实这一点需要做相应的临床试验,但是这样找到治疗胃病的药,只需要花费三年时间,成本也只有一亿美元。
这就是应用大数据思维所带来的好处。相比过去那种从病理出发分析原因,再寻找和研制药物的正向过程,今天这种做法其实是先有了结果,再反推原因,是一种逆向的做法,但是正是因为有了足够的数据支持,它无疑会比较快。 不事先作假定,从大数据出发先得到结论,再分析原因,这是大数据思维的第二层。
今天我们说大数据思维时,很多人能够想到从很多具体的数据样本总结、提炼出一般性的规律,然后加以应用。我们在前面讲通过大量的数据,消除噪音的影响,寻找信号的轮廓,就是指这个方向的思维方式。
但是,由于大数据的维度非常多,很多维度彼此独立地提供相互补充的信息,可以让我们从过去只能了解大体轮廓,变成可以把控每一个细节。我们把这样两种沿着不同方向使用大数据的思维方式,用下图中的两个箭头表示出来。
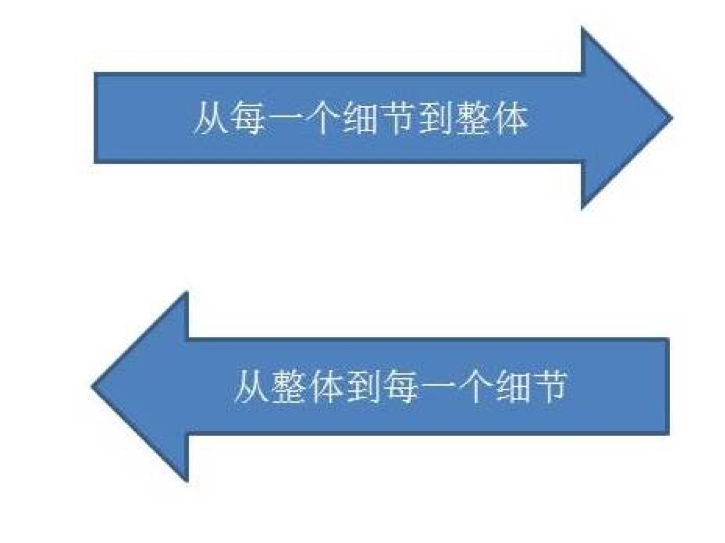
为了便于你理解第二个方向的信息流动,我不妨给你讲一个我亲身经历的例子。硅谷地区的一个连续创业者,我们不妨称之为D先生吧,他在一次创业中挣到了第一桶金,于是在几年前大数据比较热门时,他又开始了新的一次创业。
他发现,在美国一半小型服务企业,特别是餐馆、酒吧等,寿命不超过五年,很多不超过18个月。于是他花了一年的时间,调查了美国酒吧行业的情况。D先生发现,酒吧之所以经营不下去,除了一般所说的经营不善,更重要的是大约23%的酒都被酒保们偷喝了。
那么酒保们是如何偷喝掉将近1/4的酒的呢?D先生讲,其实很简单,主要是酒保们趁老板不在的时候偷喝酒,或者给熟人朋友免费的和超量的酒饮。由于每一次的交易的损失都非常小,不易察觉,因此在过去,酒吧的老板平时必须盯得紧一点,如果有事离开一会儿,只好认倒霉。
开过小餐馆的人都会有这样的经验,自己是否在店里看着,对营业额的影响特别大,因此做这种餐饮买卖的人特别辛苦,稍微不注意就开始亏损。
D先生针对酒吧老板的这些麻烦,利用大数据和IoT设计了一套解决方案。他把酒吧的酒架改造了,装上了可以测量重量的传感器,以及无源的射频识别芯片(RFID)的读写器,然后再在每个酒瓶上贴上一个RFID的芯片。
这样,哪一瓶酒在什么时候动过,倾倒了多少酒都会记录下来,并且和每一次的交易匹配上。每一笔交易,酒吧的老板都可以用平板电脑查询,因此即使出门办事也可以了解自己酒吧经营的每一个细节。
D先生对酒吧的改造带来了一个额外的好处,就是积累了不同酒吧,长时间经营的数据。在这些数据的基础上,他可以为酒吧的主人提供一些简单的数据分析。我把他提供的服务概括起来,包括这样三方面:
首先,每一家酒吧自己过去经营情况的统计数据, 这有助于酒吧的主人全面了解经营情况。在过去,像酒吧这样传统的行业,业主其实除了知道每月收入多少钱,主要几项的开销是多少,对经营是缺乏全面了解的。至于哪种酒卖得好,什么时候卖得好,全凭经验和自己是否上心,没有什么分析。D先生提供的数据分析让这些酒吧老板首先对自己的酒吧有了准确的了解。
第二项服务是,提供每一家酒吧异常情况的预警。 比如D先生可以提示酒吧老板某一天该酒吧的经营情况和平时相比非常反常,这样就可以引起酒吧老板的注意,找到原因。在过去,比如某个周五晚上的收入比前后几个周五少了20%,老板们一般会认为是正常浮动,也无法去一一检查库存是否和销售对得上。有了D先生提供的数据服务,这些问题都能及时发现。
除此之外, 第三个服务是各家酒吧数据的收集和分析, D先生会提供这个行业宏观的数据给酒吧老板们参考。比如从春天到夏天,旧金山市整体上酒吧营业额在上升,如果某个特定酒吧的销售额没有增长,那么说明它可能有问题。
再比如, D先生还可以提供各种不同酒的销售变化趋势, 比如从春天到夏天,啤酒的销量上升比葡萄酒快,而烈酒的销售平缓等等。这样有助于酒吧老板们改善经营。
2013年,D先生从硅谷几家风险投资基金获得了融资。 利用大数据在准确把控宏观规律的同时,精确到每一个细节,这是大数据思维的第三层。
大数据思维的第四个层次,是通过几个维度的强相关性,替代过去的因果关系。
我们都知道吸烟对人体有害。比如美国外科协会的一份研究报告显示,吸烟男性肺癌的发病率是不吸烟的男性的23倍,这从统计学上讲,早已经不是随机事件的偶然性了,而是存在必然的联系。
但是,就是这样看似如山的铁证,依然“不足够”以此定烟草公司就是有罪,因为它们认为吸烟和肺癌没有因果关系。烟草公司可以找出很多理由来辩解,比如说一些人之所以要吸烟,是因为身体里有某部分基因缺陷或者身体缺乏某种物质,而导致肺癌的,是这种基因缺陷或者某种物质的缺乏,而非烟草中的某些物质。
从法律上讲,烟草公司的解释很站得住脚,美国的法律又是采用无罪推定原则,因此,单纯靠发病率高这个单一事件是无法定烟草公司的罪的。所以在很长的时间里,对烟草公司的诉讼,只能不了了之。
上个世纪90年代中期,密西西比州的总检察长麦克·摩尔带领40多个州的总检察长再次对烟草公司提起诉讼。这一回,控方聘请了包括约翰·霍普金斯大学公共卫生学院教授们在内的很多顶级专家。
这些专家们派助手和学生到第三世界国家的农村的地区(包括中国的西南地区),去收集相同族群、相同收入和生活习惯等人群的对比数据。这样既排除了基因等先天的因素,也排除了收入和生活习惯等后天的因素。然后再根据吸烟是否对身体有影响作对比。各州检查官们和专家们经过三年多的努力,最终让烟草公司低头了。
1997年,烟草公司和各州达成和解,同意赔偿3655亿美元。这场胜利,标志着在法律上认可了从不同维度找到的强相关性可以取代因果关系作为法律证据。因此,用不同维度找到的强相关性可以取代因果关系,这是大数据思维的第四个层次。
今天我们讨论了大数据思维的四个层次,它们层层递进,希望大家记在心里,想想自己如何具有大数据思维。
思考题: 为什么收集吸烟的对比数据,要去第三世界国家的农村?
预告: 下一讲,我们说说Google又是怎么应用信息把广告服务做好的。
热门留言
古小千:以子之矛,攻子之盾。
用烟草公司辩解的理由,针对性的去搜集数据。比如他们提到,某些人吸烟是因为身体里有基因缺陷或者体内缺乏物质,而最终导致肺癌的。这些自身的缺乏,与烟草中的物质无关。
而美国是移民构成的国家,人们的基因差异比较大,就算是同一个城市,生活型态和社经地位也不同,而这样的现象在大都会中尤其明显。所以要能针对烟草公司辩解的理由,很难找到合适的样本。
这时大家应该就能与当时的公卫专家们想到一块了。他们往第三世界的农村地区找,因为这里基因同质性相对较高,而平时习惯和后天环境差异小,这些都是烟草公司方提出的『盾』,专家们利用大数据思维,找到了相应的『矛』。
大数据思维层层递进,未来我们都要做智能时代的人。
jwu(作者) 回复:小千讲得非常到位。
Steve:#金勇笔记# #day33# #大数据-2#
今天聊“大数据思维”的层次,跳出吴军老师文章中的四个层次,我谈两个理解。 一、从【带目的针对收集数据】到【全目的不经意收集数据】 14年我在金融行业,从事风控的数据工作。为了完成快速准确的放款目的,需要收集申请人的资质信息。申请必备信息有性别、年龄、职业、收入、用途、联系人、信用报告等。但是这种P2P的火热持续了没多久,就成为了有心人钻营的温床。
“就像是命题作文一样,申请人会按照你的要求提供一份包装好的材料,足以以假乱真”这是我在过后回顾时候的总结。
但蚂蚁金服不同,它是起家于阿里巴巴公司有了足够强的数据能力之后的产物—能把用户的消费记录与基础信息整合在一起。举例感受:
用户A的收入是每月八千元; 自我描述每月可以接受4000元信用还款额度;有两张信用卡,没有发生逾期。
用户B的芝麻信用分很高,而且支付宝使用的一年期间,虽然不知道其每月固定收入多少,但每月使用蚂蚁花呗超过3000元、曾经单次购买过3万元的电脑,并分期24月,过往还款记录良好。
阿里巴巴在非社交平台,几乎囊括了公众对互联网的全场景覆盖。几年前我还观察过Facebook、闪银这些公司试图使用社交数据进行金融服务,“你身边人的信用好, 你也不会差”。个人觉得实施起来太难。
二、系统思维与相关路径链
“头疼医疼,脚疼医脚” 我认为这句话在大数据思维下就要改改了, 因为它缺乏系统思维。 关于如何培养系统思考能力,我倒是蛮期待得到App以后可以推出系统论的课程。 它与信息论、控制论并称三论。
数据分析师通常要做很多工作是与“归因分析”相关的。比如: 为什么用户数量下降了? 为什么有的新功能用户不喜欢? 等等问题。
优秀的数据分析师会怎样处理并回答,也是我近期在想的。 我渴望认识更多优秀的数据人才,欢迎有兴趣的朋友私下联系我。
金勇分享
上周刚好看到一篇文章 《Data-As-A-Service Bible: Everything You Wanted To Know About Running DaaS Companies》 和大家分享一个概念,叫做DaaS (数据即服务),与之相对的是SaaS(Software as a Service, 软件即服务) 。 我相信目前中国与美国的数据人才缺口还是巨大的, 目前我知道北京大学在尝试在本科生中开放“数据科学”专业了,也许再过几年, 对大数据、信息挖掘的热度会再上一个水平。
金勇
2019年6月28日 零点
赵澈:收集吸烟的对比数据,要去第三世界国家的农村的主要原因我认为有以下几点:
1、烟草公司在之前的诉讼中说是因为患癌者有某种基因缺陷,是这种基因缺陷导致的癌症,要证明吸烟和患癌的相关性核心就是证明携带相同基因的人抽烟者与患癌显著相关,而不抽烟者和患癌无明显相关性,这就要求选取的样本最好能够有亲缘关系,而且聚集生活,且样本中既有抽烟者也有不抽烟者,第三世界国家的农村天然复合这个要求,他们一般都是一个大家族在一起居住,兄弟姐妹众多,基因相似度高,同时农村女人基本不抽烟,即使男性中有的人也不抽烟,这就天然的复合数据要求,只需要找到足够的数据能够证明不抽烟者患癌概率显著小于抽烟者即可证明抽烟和患癌正相关,烟草公司的托辞不攻自破。
2、第三世界国家的农村因为经济条件较差,居住相同集中,采集数据时成本显著低于发达国家,这就为采集大量数据,进行大数据分析提供了条件,如果在发达国家取数,首先数据量可能不够,光成本就是一笔不小的开销。
Hanskeng 尹桂政:这些专家们派助手和学生到第三世界国家的农村的地区(包括中国的西南地区),去收集相同族群、相同收入和生活习惯等人群的对比数据。
去第三世界国家的农村的地区,这句话其实信息量很大。首先第三世界国家主要囊括了非洲、亚洲和南美洲,这就使得不同人种的数据得以收集。而收集同族群数据后,再比较数据就可以明白:即使是不同的族裔的人,吸烟对他们的影响几乎是一致的,这就排除了患病与基因有关的谬论。
其次我们比较相同收入和生活习惯的人的信息,这可以让我们了解到生活水平相同情况下不吸烟者与吸烟者,患癌症的几率。这种比较也排除了生活水平对患病的影响。
再有,农村地区的人不像城市人一样注重对身体疾病的防御,后者往往会定期做检查,然后节制患病几率。因此吸烟对于前者来说,对其身体的影响是日积月累的,更能看出数据的准确性。
因此,我觉得选用不同第三世界国家地区的农村是有道理的。
李志杰:大数据思维的学习应用的四个层次: 第一,量变到质变,从大数据中发现之前没有的相关性。 第二,逆向思维,从结果倒推原因。不做预先的假定,从大数据中发现相关性,反过来找原因。 第三,从大数据中展现的宏观规律,精准把握过程中每一个细节。 第四,利用多维度大数据发现的强相关性替代之前的因果关系。就是拿数据说话。 联想到曾鸣老师的《商业智能》中提到的精准(精确和准确)服务,必须要有大数据这个预设条件,有了大数据,云计算能力有助于机器智能进步。
冯琨:诉讼烟草公司的案例中,烟草公司一开始就统计结果的置信提出质疑,正好这几天翻书学到了批判性评估统计研究的八个原则,这些原则不仅可以让我们在选择调查统计时选择合适的样本,也对选择数据维度、数据中的噪音、干扰因素的权重等要素做出评估。
这八个原则如下: (1)明确统计研究的目标、总体和类型。 (2)考虑来源。特别要注意研究人员自身的潜在偏差。 (3)注意样本偏差。检查抽样方法是否可以得到一个代表性样本。 (4)注意有关定义或度量目标变量的问题。变量的模糊性会给解释报告结果带来困难。 (5)注意混杂变量。如果研究中忽视潜在的混杂变量,所得结果可能是不可靠的 (6)考虑调查的问题设置和叙述。尤其要注意任何可能导致不精确或不真实回答的情况。 (7)确保结果被合理地呈现。例如,检查研究是否支撑在媒体上呈现的结论。 (8)客观地考虑结论。例如,评估研究是否达到预期目标。如果是,那么研究结论是否有意义并具有实际价值。
没故事的人:关于大数据思维的四个层次,我谈一下对我的想法。 1、用强相关性替代因果关系,这让我感到相当的诧异,作为一个理工科学生,接受的教育都是要重事实,讲逻辑,明原理。强相关性或许隐藏因果关系,但终究不是因果,相关性只是表面现象,真的能替代因果吗? 结合第二层,不事先假定,从大数据出发得到结论,再分析原因;我的理解是从事实中得到结论而非假定结论,再从结论分析原因,而非从假定的结论得到假想的原因,大数据可以说是对现实的采样,坚持从数据出发也是坚持实事求是。强相关性也是大数据所体现出来的真实世界的一部分,我们不需要从现象探究原理吗?想问的是,使用强相关性替代因果关系的边界在哪里? 2、利用大数据在准确把握宏观规律的同时,精确到每一个细节。如何在生活工作中运用这点?我的想法是,各个行业都有自己的发展趋势,从业者顺应着趋势使力更能成事。我们可以使用大数据找到行业的发展趋势,再使用数据来观察自身,管理自己,比如精力管理,高效学习计划等;既要望着远处的愿景,也要想着下一个小时的该做什么;从宏观的愿景到行动的细节,我们都可以借助数据的力量。
为什么要去第三世界国家的农村收集数据,结合其他留言,我的看法如下: 1、数据的信噪比高。对比第三世界的农村,发达国家的城市人口明显有着更好的生活条件和医疗服务,以及更高的流动性,这意味着更高的身体素质和多变的生活环境。而第三世界的农村人口的生活场所相对固定,而且物质相对匮乏,生活更接近于“原生态”,减弱了物质条件和环境变化带来的噪声。 2、采集数据的成本低。农村人口多以宗族为单位聚集居住,因此在较小范围能采集到大量携带有有相同基因的人的数据,要证明基因与致癌无关,这点很重要。而且农村地区人口不像大城市的人口注重隐私,采集数据遇到的阻力较小。
张云_AGV:为什么收集吸烟的对比数据,要去第三世界国家的农村? 原因有两点:一、找到天然的对照组,排除干扰(主要是烟草公司的那些借口);二、那里的人口流动性小,可以相对轻松地找到足够的研究样本,同时可以降低研究成本。 具体来说:第一、烟草公司为自己辩护的理由有患癌者自身的基因缺陷或内缺乏某种物质等,那么我就找到没有这样干扰的样本,这样把吸烟这个核心原因突现出来。 第二、想要找到这样的研究样本,需要在相对封闭和原始的环境中,找到大量亲缘关系近的人,无疑第三世界的农村很合适。
完美坚持:香帅老师在科技金融模块讲: “相比于粗放的工业化时代,数字化时代是一个颗粒度极小,多样性很足的微粒社会。它就像超高清的动态照片一样,可以捕捉到隐藏在数字化连接背后更具体的需求,更细微的变化。”
颗粒度小、多样性足,就对应了大数据的精确到细节、多维度完备性。捕捉具体需求、细微变化,在大数据的收集和使用中,成为水到渠成的事。特别是有时候,从想要研究的问题溯源,不带特定目的,往往能有出人意料的发现。
我印象特别深香帅老师一个例子:之前有同学提到泰隆银行通过派审查员蹲点、寻访周围居民的方式,交叉验证,中小企业贷款做得特别好的例子。
而像蚂蚁金服、京东金融这样的公司做信贷产品,商家的销售额,消费品的价格,商品的丰富度等,这些数据是现成的。此外,还有许多其他维度的数据,这些数据是大量、多维度、在线的。
蚂蚁金服就利用这些数据,去分析判断哪个商铺最适合放款。结果发现:“传统银行的信贷模型中,很多变量都不适用,一个很“淘宝”的变量居然浮现了出来:“商铺给顾客的回应速度”可以特别好地预测坏账率。”
这时再推敲原因,就不难发现:对于这些同质化竞争激烈的商铺,“最大的投入就是人力资本的投入”,因此“商铺给顾客的回应速度”快→企业质量好→违约率低。
类似的,直接研究病理,推出新药显然太费时费力,但通过大数据找到可能有效的现有药物,再研究试验,就节省很多资源。
这样先通过大数据找到多维度的强相关性,再寻找背后的原因,发展新的规律,能够大大提高效率,思路也可以推广到很多领域。
佛祖门徒:今天老师通过一些生动的案例讲解了大数据思维的四个层次,我的体会是大数据是一种全新的思维方式,我们应该从根本上改变做事情的方式与方法。 第一、大数据的科学基础是信息论,到了大数据时代,量变带来质变,采用信息论的思维方式可以让过去很多难题迎刃而解。比如流感疫情预测一直是个难题,但是Google可以通过人们的搜索记录,来预测某个地区发生流感的可能性,虽然这种预测不可能绝对精准,但概率却很高。 第二、当数据具有完备性之后,训练模型的数据集合和使用这个模型的测试集合可以成为同一个集合或高度重复的,从而大大提升效率。比如,以前进行全国人口普查,需要大量基层人员挨家挨户地入户登记。这种统计方式工作周期长、效率低下,但由于受到技术条件的制约,也只能这样做。户口登记完成后,一个阶段内分析人员都是基于样本思维在做分析和推测。 第三、在大数据分析中,常用标签的方式对一个人进行画像和归类,然后进行精准营销,从而避免将分析对象简单化。就以我们分析一个人的特点为例,我们需要利用交叉验证思维进行精准“画像”,通过对更多维度的信息进行持续观察和深入分析,才可能做出靠谱的结论。
TryTs:很多人所称的十年经验,不过是把一年的经验用了十年而已。今天吴军老师讲的酒吧的例子很有感觉,一是有感于思维方式的不同,D先生在这一点上的思维方式就比普通的酒吧老板高出好多;二是,通过数据来量化产量进行资源的分配,很多人做生意的时候不注意总结数据,可能同样的东西在不同的时间销量不一样,但是生产的还是一样的。与此同时D先生直接用更高级方法统计一个地区的销量,而不是仅仅一家酒吧。 做任何事情反馈,反思很重要,不光是让自己更加的进步,并且如果不这样做的话容易让错误,坏习惯一直重复。
Michael:吴军老师好! 对于大数据的整整递进,让酒吧的老板,保护了损失,也对自己的经营有了一个全新的认识,从整体看到细节。霍普金斯大学在第三世界农村地区做吸烟对健康的危害调查,把收入,基因,习惯,地区等都弄成相同的变量,从而推到吸烟有害健康的结论,他们的胜利标志着多维度的强相关性可以替代因果关系。 第一层:大数据的统计;第二层:查看数据的异常;第三层:根据趋势分析调节自身策略;第四层:根据数据的强相关性推导因果关系。 对于为什么要在第三世界落后的农村,想必那里的人们都是群居在一起,比较好进行调查,就是比较好拿到他们的数据,可能那时候的发达国家里面,发达国家的人群对个人数据意识很强,不容易采集。
李泽蘋:『"大"数据——求之于势,不则于人。』
"大"数据,即"大"世界。相较于小世界而言,这无疑将是一次"世界重构"。 有时候,人对数据的敏感性天然不足。 尽管明白这样那样的『分布』,这样那样的『复利』,这样那样的『指数叠加』。不管承认与否,一切似乎都很难有所突破。 天然无感,造成了天然的局限性。 那数据,或者说,大数据能起到何种帮助呢? 或许有些冒昧,一直敬佩吴军老师异于常人的自律是如何做到的。 那我想,除了精神品质以外,就是无形中化用了大数据思维:不急于眼前,而着眼大局(终局);不着急现在就吃到糖果,以后或有更好的。 你看,自律可计算,个体可数据。
全能自恋丁某人:因为美国是一个多人种的国家,移民,留学的很多,而各个人种之间的基因是有先天差别的,因此在美国收集出来的吸烟数据不能排除基因这个先天的因素,所以要来到第三世界国家的农村,这里的人种都是黄种人,大家基因一样,就排除了先天基因的干扰。
而在农村大家的生活都差不了太多,因此生活习惯都比较接近,甚至相同。并且只要地皮数量差得不多,收入自然也差不了多少。这样就排除了工作收入和生活习惯这两个影响身体情况的因素。
在排除了这三个因素后,再通过对比当地吸烟者和不吸烟者的肺癌患病率,就可以得出足以推倒烟草公司提出的辩解的结论了。也就是肺癌并不是因为基因缺陷或者身体里某种物质的缺乏而导致的,而是吸烟导致的肺癌。这就宣告了胜利。
中武妖:吴军老师,之所以要去第三世界的农村去收集对比数据,就是因为数据要纯粹和排除干扰,作为一个三线城市的人很有发言权的。到过大城市的人都知道,大城市的环境真的是考验人的身体,到处是污染源,比如汽车是尾气,水污染,工业废物和生活垃圾,噪声污染,工作压力,土壤污染农药等等。如果到过三线城市的农村就会发现,真的是到了一个非常干净的环境,水,空气,环境,噪音基本上都是处在自然状态,而且只要没有什么不良习惯可以活的非常健康。只有在这样的环境下才能真正的通过数据对比产生价值,因为大城市的一些疾病在农村其实是非常少见的。所以这就是为什么要去第三世界的农村去收集对比数据,就是因为这样的数据是排除干扰,排除了噪音的。只有在这样的数据下才能发现等价信息,如果只是在城市中随便收集一些数据,烟草公司就会提出很多的疑义,因为在城市中有太多的噪音会让产生同样的疾病。这也是为什么在获取信息的时候,最重要就是排除噪音,让数据产生强相关性。
头发末梢的遗憾:记得吴军老师在《智能时代》一书中,专门讲过这个问题。第三世界农村,由于族群相对单一,收入和生活习惯相差较小,可以排除基因先天因素以及后天生活影响因素,而这个人群相对比较庞大,可以产生足够样本,来对照香烟造成的伤害,找到强相关性。
周稳:由于第三世界的农村居民可以说是当下亚健康系数最低的群体了,去第三世界的农村就是为了尽可能减少干扰因素诸如生活富足所带来的肥胖症、夜生活丰富所带来的作息不规律等等所造成的影响,这样一来可以让检测得来的数据具备强相关性,抽烟群体与不抽烟群体的身体素质的长期对比一目了然
方兴(阳光芳草):之所以从第三世界收集的信息更有说服力,是因为这些国家的居民生活环境比较单一,相近居民的相似性更高,因此更容易判定吸烟对他们的健康的影响,这也许也是一种人为减少信息库里噪音的方法,更加容易找到信息的相关性。
大数据思维对于个人也很有益处: 1)数据百川入海,我们平时要注意自己的信息源,维护自己的人脉,让自己尽可能得到不同源头的高质量的信息。
2)在数据里形成结论,而不是自己单纯的推理; 用广泛的数据来形成一些规律,这些规律比自己的单纯推理更快更有效,之后在这些规律里形成一些正确的更有说服力的结论。人得认知错误往往因为过快的给出结论,注重数据里的规律,可以帮助我们得出正确的结论。
3)把握宏观规律,注意细节 宏观规律的把控,再加上对细节的推敲和把握,才能处于有竞争力的地位,细节的极致方面德国和日本是榜样。日本客户通过邮件发稍微重要一些的文件(比如订单)都要加密码保护,这个小细节就说明了他们的安全意识和注意细微处的优势。
4)用多个维度的强相关性来说明因果关系 带着系统性思维的角度,找到事物之间的连接关系,再通过数据来梳理之间的相关性,来理清因果关系。
以我们了解一个人为例,我们要收集多方面的信息,汇集不同视角对此人的判断,比如巴菲特是世界顶极富豪,可是他也许不是一个称职的丈夫和父亲;我们要在数据里寻找规律,此人在不同身份里做过什么事,成功和失败都是什么,是否好学精进;我们要宏观看待此人,在细节里找到了解这个人的信息;要从多维度的强相关性来分析此人的行为的种种因果;大数据思维又是我思维库里的一件好兵器!
KID:第三世界农村,隐含信息是 贫穷:消费能力差,医疗卫生差,人员流出大于流入,减少外来基因干扰。 落后:生活方式单一,食物种类少,同区域大家吃得都差不多,减少食物带来的对每个个体健康影响的干扰。 文化水平低:生活习惯差,不讲究卫生,对身体疾病关注度低。 地域范围广:第三世界主要分布在亚、非、拉地区,气候差别大可以,每个区域样本数量多,且同区域内基因同质性高。 因此如果同区域内基因相似性大,但是吸烟与没吸烟的患肺癌几率差别大,则说明“身体里有某部分基因缺陷或者身体缺乏某种物质,而导致肺癌的,是这种基因缺陷或者某种物质的缺乏,而非烟草中的某些物质。”这个观点是错误的。
Silas:去第三世界国家的农村收集相同族群,相同收入和生活习惯的对比数据.这句话可以拆开两个部分来看. 1.第三世界国家包括了亚洲,非洲,拉丁美洲以及其他地区中的发展中国家.这样就有了庞大的数据量.对比不同地区和种族的差异,就可以排出基因的因素. 2.农村.在农村生活的人联系比较紧密.相互之间的影响比较大.生活水平,生活习惯都比较类似.相关性强.在后天条件差不多的情况下,通过对比吸烟人群和不吸烟人群的发病率,就可以得出吸烟是否与肺癌有正相关性.
32|大数据(二):大数据思维的四个层次
https://note.haoshenqi.top:/?p=category-xin-xi-lun-40-jiang-34
评论