08|矢量化:象形文字和拼音文字是如何演化的?
08|矢量化:象形文字和拼音文字是如何演化的?
你好,欢迎来到我的《信息论40讲》。
我们在第6讲,讲了有效编码的原则,可能有同学会想,按照那两个原则,我们的文字,无论是西方的拼音文字,还是东亚的方块字,都不算完美,一方面有些字长得有点像,比如人和入,土和士,没有上下文不好辨认,不符合易识别的原则,另一方面大部分文字作为编码也不高效。
就说英文单词吧,用5个字母就能拼出1200万个单词,即便扣除掉iiiii、jjjjj这种不合理的,也能拼出几十万个看起来很“合理”的英文单词,要是这样的话,所有单词只有5个字母,大家不就不需要背那些很长的英文单词了吗?
对这个问题简单的回答是,语言和文字是慢慢演化过来的,而不是人为利用信息论的编码原理刻意构造的,因此不可能只照顾易辨识和有效性,而不考虑人类接受它们的难度,以及演化的过程。
相反,人们给计算机识别的单词,比如汇编语言的指令代号,基本上就是很短的、等长的字母组合,因为那是完全利用编码原理人工设计的。
当然,在人类文字演化的过程中,也无意间用了一个信息论的原理——信息的矢量数字化(也被称为VQ),或者简单地讲就是矢量化。
今天我们就从文字和语言的演化过程,来谈谈这个原理以及它们的意义。
人类在进入到文明社会时,活动的范围越来越大,需要记录的信息越来越多,人类就开始通过动词和名词的组合来表达复杂的意思。
但是新概念、新事物还是不断地涌现,人类只好造出更多的象形文字,这就如同今天人们不断创造新词一样。 信息越多,需要的编码越多,这是文明自然演变不可避免的过程。
太多不同的编码(文字)出现后,就要对编码进行简化,否则大家就没法学习了。而简化的自然过程,就是矢量化的过程。
那什么是矢量化呢?你一定有这样的经历,就是把一张图片放大再放大,通常就会模糊,出现马赛克甚至锯齿。
学计算机的人知道,计算机中使用的字体有位图(bitmap)和矢量图两种。位图一经放大就会出现锯齿,而矢量图随便放大,都很清晰。这是怎么做到的呢?
我们先从信息的矢量化说起。
我们假定有一些几何形状,它们具有不同的颜色。比如下面这张图:
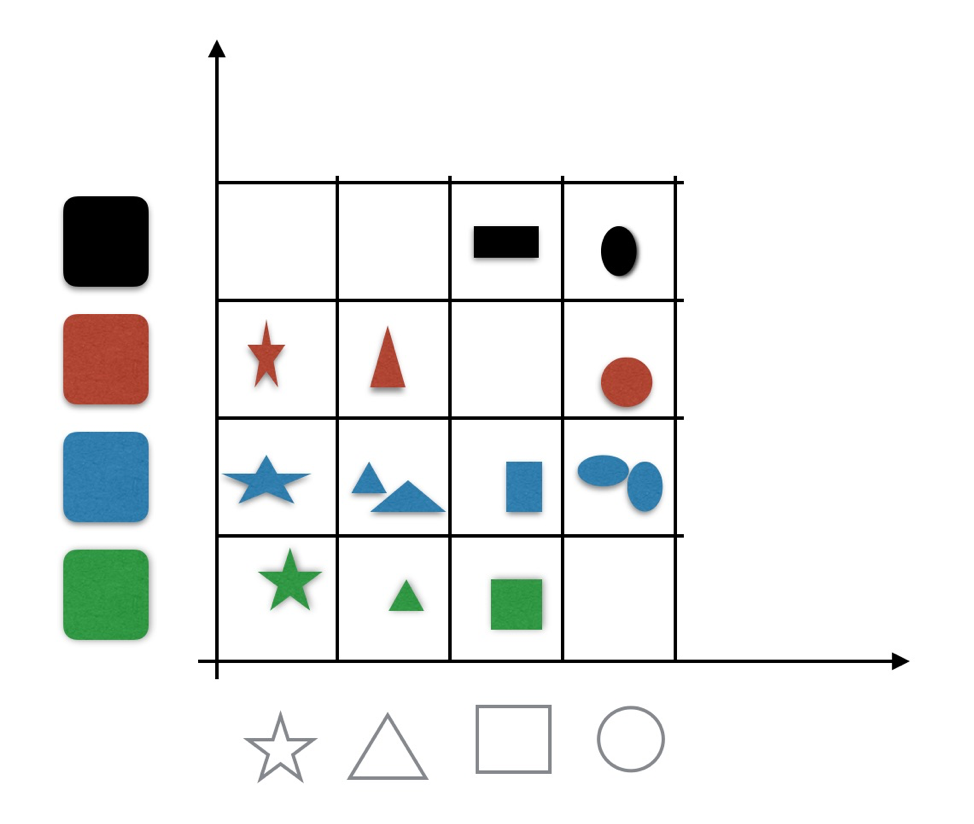
这些基本的图形彼此有一些相似性,但是又不完全一样。我只画了十四个不同的形状,当然真实的情况是它们可能有成千上万个。
这么多图形,我一个个描述太复杂,于是我们就把这成千上万个彩色的形状,按照颜色和形状两个维度各四种情况,分到了16个格中。
这样,所有的图形,就被归为了16类。当然,其中还有四个格子没有信息,因此可以看成是不存在的。这便是矢量化的原理。
这个用坐标分类,概括多种形状,就是形状的矢量化过程。当然,如果我们分类所概括的是信息,不是图形,道理是一样的。
为什么这种特殊的归类过程,我们称之为矢量化呢?因为当我们把杂乱无章的信息投射到两个维度之后,两个维度坐标可以决定平面上的一个矢量。
比如在上面的例子中,要找圆形和椭圆形的蓝色图形,就用下面这个从原点出发到(4,2)坐标的矢量来表述:
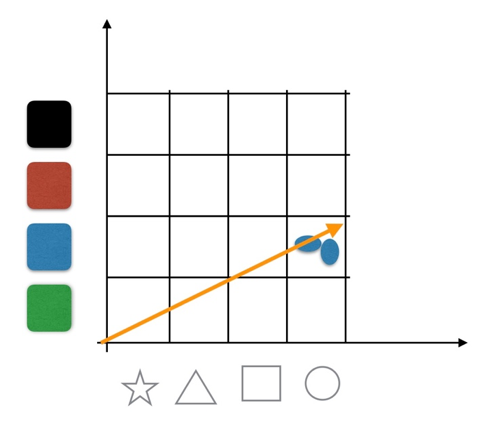
当然,通常将信息投射到两个维度是不够的,根据应用场景会投射到多个维度中,这样的过程就被称为矢量化。
人类象形文字的演化,实际上就是这样一个矢量化的过程。 我们不妨先看看各种象形文字演化的过程。
文字演化的第一步是抽象化。下面一张图描述了美索不达米亚文字(上)、古埃及文字(中)和古代中国的文字(下),对“鱼、鸟、戚、矢(“有的放矢”的“矢”,也就是箭)、壶”这五个字抽象化的过程。
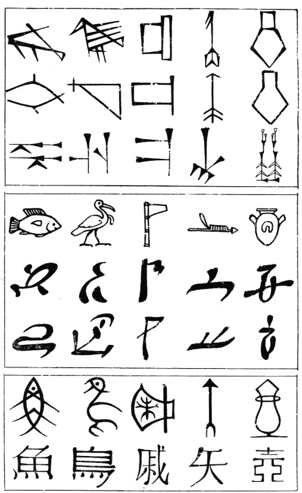
你可以看出最初的文字和真实的物体非常相似,但是这些象形文字彼此之间缺乏共性。
但是后面逐渐地,它们就被抽象化成一些直线或者弧线了。在中国和美索不达米亚,由于早期的文字是刻在金石、竹木和泥板上,因此,更多被抽象化成点和线的组合,这样便于刻写。
而古埃及是写在莎草纸上的,能够使用曲线书写,因此多用曲线进行抽象化。但不管怎么样,抽象化之后,就可以总结出共性了。
接下来第二步,我们就以汉字为例来说明矢量化的过程。
绝大多数汉字被映射到两个维度上,即一个表意的偏旁维度和一个提示读音的发音维度,有些时候,提示读音的维度本身也表意。
再往后,表达含义的偏旁已经和原来的图画不太像了。而这些偏旁就构成了文字的基本单元,而且慢慢固定下来了。
以后有新的概念需要创作出新字时,使用那些基本单元,即偏旁部首,重新组合就可以了。比如唐朝的宗秦客为武则天发明了一个“曌”字,意思是日月当空,献给武则天拍马屁。
当然,很多古代人所表达的信息今天早已经过时了,因此大量的古体字其实今天已经废了。虽然《康熙字典》里收集了47000个汉字,但是3000多个一级国标汉字已经能覆盖今天98%以上的文本了。
类似地,在《牛津词典》中有大约1/4的词今天已经不用了。今天的人,更习惯于用现有的字发明新词,而不是造字。
好,说完了象形文字的演化。 我们再看看拼音文字是如何矢量化的。
拼音文字的简化主要是围绕读音进行的。在美索不达米亚人发明了楔形文字后,它很快就由象形文字变成了拼音文字。但是那些拼音文字并不简单,每一个表达意思的拼音其实是一堆很复杂的小箭头(很像楔子,所以也被成为楔形文字)。
后来楔形文字被当地的闪米特人学会了,他们中间有一支非常善于远洋经商的族群——就是腓尼基人。
腓尼基人将美索不达米亚的文字传播到地中海各岛屿。但是,在经商途中,商人们可没有闲情逸致刻写精美漂亮的楔形文字,于是他们对这种复杂的拼音文字进行了进一步简化,就剩下几十个字母了。
可以讲,从复杂的楔形文字,变成简单的几十个字母,是一个巨大的进步,它使得人类学习读写变得很容易。再后来希腊人从腓尼基字母中总结成24个希腊字母,而罗马人又将它们变成22个拉丁字母。
随着罗马的扩张,征服了很多外国土地,吸纳了很多外国人,有些外国的人名和地名就无法表示了,于是罗马人在字母表中加入了x,代表所有那些无法表示的音和词,这既是英语里包含x的单词特别少的原因,也是后来人们用x表示未知数的原因。
再后来拉丁文里的i被拆成了i和j两个字母,v被拆成了u,v,w三个字母,最终就形成了今天英语的26个字母。
今天欧洲其它的拼音文字大多源于拉丁语,虽然它们字母表的多少略有区别,而且读音不同,但是写法上相似,因为同一种写法表达的是同一条信息。
虽然象形文字和拼音文字的形成和进化代表了两种不同的信息编码方式,但是它们都利用了信息论中矢量化的原理。
在欧洲的拼音文字中,虽然没有表达意思的偏旁部首,但是有很多词根,前缀和后缀起到了表达意思的作用,也就是说这些语言实际上将表达信息的基本单元(单词)用一个词根、前缀、后缀这样三维的矢量表示了。
于是,稍微有些语言基础的人,可以猜出一些没见过的单词的含义。正因为这个原因,拼音文字比汉语容易学。
在近代史上,曾经有不少学者提出过将汉字改为拼音文字,但其实这是不可行的。比如你把计算机变成jisuanji这几个罗马字母,它完全没有词根、前缀和后缀,因此猜不出意思。
信息的矢量化这件事应用的场景非常广,前面提到的矢量字体就是一个,它的原理是将字体的轮廓映射到一组曲线上。在显示(和打印)时,经过一系列的数学运算,恢复字体的形状。
这一类字库不仅占用空间小,而且从理论上可以被无限地放大,笔划轮廓仍然能保持圆滑,非常美观。
此外,矢量化在生活中也有应用,比如我们通过高考成绩录取大学生,或者通过身高选拔篮球运动员,其实就是利用矢量化的原理,只不过是将所有的人映射到了一维的空间中。
这种做法给工作带来了极大的便利性,但是显然没有全面地考察每一个人,或者说有信息的损失。
所以,在信息论中,一个更有普遍意义的问题就是,矢量化会带来多大的信息损失,关于这一点,在信息论中有一套理论计算这种损失。
而在工程中大家要做的事就是,如何平衡便利性和信息上的损失。人在年轻的时候,总是会想两者兼而有之,学习了各种科学知识后,就知道这种事情在理论上是办不到的。
要点总结
-
我们从文字的演变,介绍了信息的矢量化这个概念,以及它的应用。
-
我们进而讲述了,无论是象形文字还是天然形成的拼音文字,都通过两到三个维度的矢量化兼顾了读音和达意的关系。但是,如果强制将中文拼音化,它将失去达意的功能,这不符合信息论的原则,因此做不下去。* 世界上人为想做的,但违背规律的事情,做起来总是困难重重。
-
在生活中其实也有很多矢量化的例子,* 它们让问题变得简单,但是会丢失信息,而平衡便利性和信息的完整性,就成为了艺术 * 。
思考题: 如果你是一家公司的人事经理,年底时要设计一个对员工进行评估的方案,利用矢量化的原理,怎样设计方案比较好呢?
预告: 我们还留下了一个问题,为什么说中文比西方拼音文字更精炼,也因此更难学?这个问题我们下一讲再说。下一讲见!
热门留言
Steve:#金勇笔记# #day8# #总结#
案例补充—什么是矢量化?
人类对现实世界观察、记录、分类,在这个过程中就产生了文字,可以说矢量化是记录到分类不可或缺的步骤。
假设我要绘制一个圆,我要告诉计算机哪些信息呢? 你可能会说:半径、圆心坐标、轮廓的样式与颜色。 那么我就将这些“画圆的心法”,也就是信息,保存起来,但并不原模原样地画出来。 当我需要一个圆时,就拿出这个矢量图的基本元素,算一算,就得到一个新的图形,因为有基本信息在,放大也不会出现马赛克。
金勇分享 - Friend Me
我想从实用角度补充一个吴老师的观点:“人们更喜欢用现有字造词,而不是从头造字。 ”
Facebook出现后,美国人见面就会加一句:“在Facebook关注我!来加个好友!” (Friend Me!)你看, friend这个词原来是名词,现在有了动词的意思(与...成为朋友)。 再到后来,取消关注的需求也强烈了。于是出现了一个新词 “defriend”,这里“de-”的前缀就带有去除、解除的含义。 这就是一个利用词根词缀等矢量维度,推进语言演化的例子。
延伸阅读 - 几种常见的图片格式
JPEG, PNG, BMP是我们平时最常见的图片格式了。 下面简单的介绍一下它们的特点: *BMP(BITMAP)就是位图,精确但严格,10X10的图片放大成100X100会变得很模糊。 *JPG(JPEG)使用最为普遍,它采用了一种失真压缩标准方法。 *PNG格式是无损数据压缩的。
说到这,也许你应该开始疑惑,到底什么是数据压缩呢? 为什么不能把原本的信息原原本本的表达出来,压缩的意义在哪里呢? 先卖个关子,随着课程进行,我们过几天就知道了。
Allelujah 朱磊:矢量化的本质,是通过不同维度的规则来压缩一套符号中的信息量,从而使一套符号能够表达、传递更多的信息,更便于应用。
公司考核体系中的KPI和OKR的本质,也是将复杂的信息通过矢量化压缩,从而使考核本身得以指标、体系化。
是以,如果要设计对员工进行评估的方案,参考矢量化的思路,就是尽可能通过几项可以量化的指标来展示每一位员工在一年中的业务表现。
而中文比西方拼音文字更精炼,是因为同样长度的字符被压缩进了更大的信息量,也因此不同字符组合的信息量会成指数增长,从而极大提高记忆和应用的难度。
泓清:豁然开朗,为什么在宁向东老师的《管理学课》中会反复的使用“四象限图”,并一再强调画图的重要性,就是要把现实中复杂的事情矢量化,便于判断和决策,管理学也是基于信息论的啊。 对员工的考核,就可以结合矢量化原理,把简单粗暴的KPI数字,转换为“四象限”图中的坐标原点,用工作态度和个人业绩分别作为横纵坐标,所有数据直观的映射到这个简单的矢量图中,不仅可以通过每个人在坐标的位置给予奖励,还能找出员工的薄弱点,下一年有针对性的进行培养。
卓克:忍不住想,X,这个字符相比所有比它更早出现的字母写起来都更简单,也不容易混淆,怎么却是后来用于表示“不知道怎么读”的一个候补呢。我想可能是字体的缘故,最初的X,也许并不怎么简单易写,可能是曲里拐弯的一种样子。
shzhang:矢量化通过老师图形的例子和金助教画圆的例子,我觉得矢量化应该是提炼的一种算法吧,尽管不能确保信息的完整性,却能在简洁的算法下,确保能再次按照这样的规则再次重现信息。
老师今天的思考题,让我想到了一个业绩考核的方法:平衡计分卡,它从财务、客户、内部流程和学习成长四个方面来进行考核,既可以用于组织的考核也可以用于个人的考核(或规划),它的原理就在“平衡”上,还不是硬性地具体表述要考核的指标,而是寻求:战略与可操作指标、长期目标与短期绩效、非财务绩效与财务绩效、内部服务与外部服务等各种要素平衡在一个考核体系中,以便确保考核的相对公平性和效率性。
路克:矢量化的过程就是用户画像!把信息的不同矢量表达出来!人力资源评估也是一个样的。找到多个有效的纬度,用可量化的数据表达出来,一个立体的人就出现了!就像英语单词根据词根就能猜出意思,汉语也可以拆词知道意思! 信息的目的是为了解决不确定性,不确定性越大,需要的信息矢量也越多,反之则少!
Dx:矢量化,想到了矩阵运算。最小误差,想到了余差的计算。 不知道文中说的矢量化的损失计算是不是使用类似方法。
对于中文与英文人类辨识的比较,我这里思考到一个角度。 如果用矢量化思考,每一个英文单词是一个2维矢量。 维度1,单词的每个字母位置。维度2,每个字母位置的具体字母。 例如hi, 所以hi的矢量坐标是(1, h=8) (2, i=9) 而对于中文,每一个文字,就要包含至少4个矢量维度。 维度1,基本笔画的种类,如点横竖撇捺。维度2、3,基本笔画在纸上的位置。维度4,基本笔画的缩放比例。甚至维度5,基本笔画的旋转。(笔顺维度可不记录) 中文的词语至少要再加1个维度,就是每个字的位置。所以识别一个中文词语至少需要识别5个维度的信息。 这样来看,中文通过更高维度来表达信息,相当于用了更高的进制(各维度进制的乘积)。而英语单词则用了更低的进制。 所以中文表达同一段信息,用了更低的编码长度,而英文需要更高的编码长度。 在古代,信息记录的成本高昂,更高进制的信息,意味着更低的记录载体消耗。 但单位面积下,传递的信息更多,拆解和识别信息更困难,这可能是象形文字更难学的原因。
像风一样自由:【今日体会】——矢量化 今天的课程有点难。我理解矢量化的过程就是一个抽象的过程,把具体的事物抽象化,从多个维度来描述这个事物。比如:我们介绍一个人,张三,男,北京人,1980年5月出生,北京大学汉语言文学专业,硕士学位,身高175厘米,体重70千克。以上信息从不同维度描述了一个人,是否可以理解为将一个人矢量化的过程… 虽然通过这些信息,我们可以了解张三的基本情况,但是对于一个女孩子来说,绝对不能凭这些信息,就决定和他搞对象[捂脸]。因为这些信息有遗漏,不完整。
佛祖门徒:我们公司每年都会采用“胜任力模型”对员工进行综合评估,测评从五个方面三十来个维度进行,主要包括: 知识,某一职业领域需要的信息(如技术开发的专业知识);技能,掌握和运用专门技术的能力(如英语读写能力、计算机操作能力);社会角色,个体对于社会规范的认知与理解(如对于部门主管的定位);自我认知,对自己身份的知觉和评价(如对自己在某一领域的水平定位);特质,个人所具有的特征或其典型的行为方式(如冒险还是保守);动机,决定外显行为的内在稳定的想法或念头(如对于权力或财富的态度)。 考评分为自评、互评和点评三个方面,根据最终得分确定员工的人岗匹配度,对于薪酬管理、培训计划、提拔任用等方面都形成了较为全面的决策依据,还会采用一对一谈话模式,宣布考核结果,并指出员工进一步努力的方向。
小贝:我们为了认知复杂的世界,必须对很多事物进行抽象化,以便于大脑的记忆和理解。我的理解,矢量化是我们抽象化事物的一种方式。
刘润老师讲的很简明,“不抽象,我们就无法深入思考;不还原,我们就看不到本来面目。”
以前在我们的大脑中,“信息论”是一个抽象的概念。我想吴老师的课,就是在带领我们把这个抽象的概念,还原它本来面目的过程。
日积月累:汉字的矢量化大多是二维的:用偏旁表意,用部首表音。而英文的矢量化则为三维:词根表音,前缀表意,后缀也表意。所以,中文的信息损失更大,更难学。 作为一名人事经理,我想要考虑的纬度包括员工的履职情况、部门的业绩对比、客户的反馈信息、同事的评价等等。所以,为了在信息的便利性和完整性之间取舍,我仅选择从内、外、主、客四个主要纬度制定方案,并会坚持在实践中不断优化、调整。
夏雨雪:#吴军信息论# 【编程语言的矢量化】
编程语言,总是在简洁性、易读性、高性能、易用性等多个维度中不停的演化。
最早期的汇编语言,是最接近机器语言的编程语言,占用空间很小,但是易读性很差,使用起来也不太符合人的习惯。
后续慢慢出现各种各样,应用在不同平台上的高级编程语言,无一例外的首先照顾了易读性,使用起来也更方便了。但是编译以后占用的空间也更大了。不过没关系,因为现代计算机,无论是内存还是硬盘的空间,都得到了大幅的提升。
所以,信息的矢量化,尤其是给人直接用的时候,往往会随着时代的发展,带着很多冗余的信息。这个冗余的部分,看似没必要,但是我们离不开。一旦离开了,这个信息就不好辩识。
AJ:衡量一个员工一年多表现,可以参考体育界球员数据的雷达图。 以NBA球员为例,指标如下,得分,篮板,助攻,抢断,盖帽,失误,犯规数,正负效率,等,然后把这些指标放入一个圆形里,围绕圆心依次排开,内个指标占用一个扇区,而圆心到圆周的距离就是该指标的最高分数。 于是,把每个球员在一个赛季里的雷达图表现拿来对比,就很直观。 对应公司员工而言,只要把指标换成相应的部门需要的工作内容标准即可。 比如,评价销售工作一年的表现,设定,销售额,回款额,销售达标率,回款达标率,报销额,报销占回款比,出差率,新客户开发率,老客户回头率,等。这些指标可以无限多,只需要根据公司实际业务情况来挑选组合即可。
方兴(阳光芳草):矢量化原理很有意义。
语言的目的是记录,沟通以及传播,在其发展过程里,简化和矢量化是必不可少的步骤,因为它能最有效率得来表达,但是矢量化也会导致很多时候我们的思考不全面,因为在此过程里流失的一些信息。
由此得出: 1)有时候要避免自己思考的矢量化,总是,一贯如此,某某人是一个什么样的人,都是一些带有评判性质的思考和结论,局限不全面;
2)要争取在某些情景下恢复信息,某某人是一个什么样的人,真的吗?他具体做了什么事?他说了什么,做了什么?有什么反例吗?别人会怎么看这个事?
3)有时候要有意识得去矢量化,在大量事实和信息里找规律,找本质,然后用这些规矩和本质来串联信息。日本有一种读书法,就是找出书本里的关键词,然后把关键词写进16宫格来串联信息,非常有效。
4)要成功有时候就要反自己的矢量化,要在人群里成为特例,做一些很难被矢量化的事情。
如果我是HR招聘,我会首先立下标准,将他们矢量化,之后再立下一些内部具体操作的通融的特例,以便确保优秀人才不被错过。
小瑜:矢量化很像机器学习上的“特征工程”,比如因子分析和PCA降维。特征工程要求抽象出来的特征足够明显,并且在有效概括事物特点的同时不丢失核心特征信息。
吴军老师谈到这是一个艺术时,我就想到了《黑客与画家》里面提到的对事物进行有效抽象的共同点。典型例子是抽象派画家毕加索在1946年画公牛的过程。毕加索前后一共画了11个版本,从肌肉纹理可见的具象版本,到最后只有不到10条线条的版本,毕加索抽象出了以下5个矢量:
- 弯弯的犄角
- 宽大的身躯
- 长长的尾巴
- 粗壮有力的后腿
- 必不可少的小丁丁
以上的5个特征其实就是一头公牛被矢量化时的5个维度。感兴趣的童鞋可以百度“毕加索 公牛”就可以找到当初毕加索对公牛矢量化的11个版本。
图哥Pat:我思考一个大问题时最爱用的软件就excel,没有之一。现在想来就是在借助excel展现维度的便利性,帮我进行矢量化的思考。
如果我是人事经理评估员工,我的理解这实际上是“公司对员工投入产出比的分析”的等价问题。
那么我脑海中首先想到的是员工“产出”和“投入”两个维度,这是我最先会输入excel表格的,但我很清楚这只是最粗略的矢量化的第一步。
“产出”包括但不限于:完成的销售额,节省的时间,提高的效率,客户满意度提升…… “投入”包括不限于:工资,奖金,提成,社保福利,培训,假期…… 现实里,要考虑解决问题的便利性,不用穷举上述所有矢量化的维度。评估员工的目的要取决于公司领导的主要意图,选择关键维度输入excel,进行矢量化分析。
白雀:我们在中学的时候就学过,一个量是标量还是矢量,就看包不包括方向的影响,所谓平行四边形法则、力的合成之类的都是和方向的影响有关。但是这里讲的信息的矢量,好像没考虑方向的问题,我甚至理解上认为是在说“多维度”,比如那个颜色和形状的坐标图,就是从两个维度来查找信息。
这种做法在生活和工作中十分常见。有些人运用的好,就会给自己以很大的便利。
比如,工作中的个人电脑的文件管理,有些人按照时间顺序管理文件,查找起来就会很杂乱。有些人按照项目类型、负责人等维度标注,查找起来就很容易。
多维度标注一个信息,起到的不仅仅是优化查找的作用。这是我今天的所得。
前两天把之前的问题想了,今天又来了个问题:吴老师讲,人们想做的事情,如果违背了自然规律,做起来就会困难重重,《谷歌方法论》也讲到,不要做个妄人,不要有妄念,要不断学习,提高自己的认知边界(底线那条边),那我想问,还有没有别的办法能较快的破除“没做成可能是因为不够努力”的不靠谱想法,因为我们都知道很多事情没做成不是因为不够努力,而是根本就不可能做成。
方云轻:在数学里,矢量化后各个basis需要独立且正交,反映在现实生活中,就是每个矢量化后的坐标轴要尽可能的独立、不重叠、不覆盖,并能够体现整个空间的信息。所以要用奥卡姆剃刀,把评估模型做得简洁明了,关注最重要的要点,剃除其他点。 作为一名人事经理,对员工评估要切合公司的发展。小规模的公司要注重个人能力,矢量化后评估模型接近一维,以业绩为主。大规模的公司要注重塑造铁打的营盘,矢量化后评估模型为多维,员工业绩(30%)、营盘的建设(70%,可分为营盘的搭建subdimension1和对新进入营盘员工的培训subdimension2)都要考虑。
吴强:矢量化是把多维度的信息投射到少维度的坐标中,这个过程会把投射者不关注的信息抹掉,没有被投射的维度不是没有,而是相对不重要。 设计员工评估方案,就是一个精简维度的过程,从多维度杂乱的信息中挑出关键维度的信息,形成业绩指标,比如销售额、产品合格率等,用有限的信息尽可能还原员工的真实工作情况。
TryTs:之前吴军老师讲过的“算法”也是这么一回事,在“时间”和“空间”上做平衡,“时间”来省“空间”,或以“空间”来节约“时间”。生活中许多时候往往是“鱼和熊掌”的关系,很多时候心存侥幸妄图两者都“得”,最后往往是“竹篮打水”,什么都得不到。
08|矢量化:象形文字和拼音文字是如何演化的?
https://note.haoshenqi.top:/?p=category-xin-xi-lun-40-jiang-8
评论